

1. 서 론
2. 본 론
2.1. 발생 가능한 시나리오 설계 및 시범 구간 선정
2.2. GNSS 네트워크 RTK기반 정밀 측위 데이터 수집
2.3. 가시광선 카메라 기반 선로주변 시설물 영상 수집
2.4. 철도 시설물 이미지셋 구축 및 객체검출 모델 적용
2.5. 시범구간 운행 데이터의 분석 및 가공
2.6. LSTM(Long Short Term Memory) 딥러닝 예측 알고리즘 검증
2.7. 선로작업자용 열차 접근 경고 애플리케이션
3. 결 론
1. 서 론
열차 지연은 승객 불편과 직접적인 사회적 비용을 초래한다. 국내 열차 지연에 따른 배상 규모는 2019년 약 9.6억 원에서 2022년 약 46억 원, 2023년 약 31.5억 원, 2024년 약 32억 원, 2025년 약 46억 원에 이르는 등 매년 큰 폭으로 증감을 반복하며 누적되고 있다. 한편 선로 주변에서 작업하는 작업자는 소음과 진동이 발생하는 환경에서 열차의 접근을 인지하기 어렵고, 열차의 운행·위치 정보가 부정확할 경우 중대한 안전사고로 이어질 수 있다.(1) 따라서 정확한 열차 도착시간 예측은 승객 편의와 선로작업자 안전 모두에 직결되는 과제이다.
현재 열차 간격 제어를 위한 위치 검지는 주로 궤도회로를 통해 해당 구간의 열차 점유 여부를 확인하는 방식에 의존한다.(2) 그러나 이 방식은 궤도 내 열차의 유무만을 판별할 수 있을 뿐, 열차의 정밀한 위치를 연속적으로 파악하는 데에는 한계가 있다. 고속 주행 환경에서 짧은 시간 안에 정확한 도착시간을 산출하려면, 차상 장치의 속도·위치 신호를 보정 데이터 및 지점별 고정 위치와 결합하여 정밀한 도착 정보를 신속하게 제공하는 기술이 필요하다.
최근 도착시간 예측에는 시계열 학습에 강점을 가진 LSTM 등 딥러닝 모델이 활발히 적용되고 있다.(3) 그러나 이러한 모델이 실제 운행 데이터에서, 그리고 단순한 통계적 기준선과 비교했을 때 실질적인 이점을 제공하는지에 대한 실증적 검증은 충분하지 않다. 특히 동일 열차가 정해진 시각표에 따라 반복 운행하는 정형적 환경에서는, 과거 운행 이력만으로도 상당한 예측력을 확보할 수 있어 적정 기준선(baseline) 설정이 모델 평가의 전제가 된다.
본 연구는 공공데이터포털의 운행실적 OpenAPI와 실차 탑승으로 취득한 GPS 데이터를 결합하여 단일 운행계통(No.1157 열차)의 구간 통과시간 데이터를 구축하고, 이를 이용해 LSTM 기반 예측 모델과 과거 이력 기반 베이스라인을 비교·실증한다. 본 연구의 기여는 다음과 같다. 첫째, 공공 운행실적과 실측 GPS를 결합한 재현 가능한 실데이터 예측 파이프라인을 제시한다. 둘째, 데이터 누수를 방지하는 날짜 기준 분할 하에서 LSTM과 이력 기반 베이스라인을 비교하여, 정형적 반복운행 환경에서 단순 이력 통계가 강력한 기준선이 됨을 정량적으로 보인다. 셋째, 예측값에 기반한 이상(지연) 판정 절차를 제시하고 그 한계를 함께 분석함으로써, 향후 도착시간 예측 연구의 평가 설계에 시사점을 제공한다.
본 논문은 국토교통 기술사업화를 위한 이어달리기사업 “승객편의 향상 및 선로작업자 안전관리를 위한 고정 GNSS 보정기술 및 정상·비정상 운행특성 패턴 인식 기반 철도차량 도착시간 예측모델 개발(과제번호: RS-2024-00412679)”의 지원을 받아 수행되었다.
2. 본 론
2.1. 발생 가능한 시나리오 설계 및 시범 구간 선정
본 연구는 도착시간 예측 모델이 대응해야 할 운행 환경을 구체화하기 위해, 철도 운행 중 발생 가능한 이벤트 시나리오를 먼저 설계하였다. 시나리오는 열차 운행 업무 전문가와의 사전 인터뷰를 바탕으로 작성하였으며, 이벤트의 발생 조건과 원인을 고려하여 본선 선로에서의 적용성이 높은 상황을 중심으로 구성하였다.
이벤트 분류는 「철도안전법」 및 「철도사고·장애 의무보고 지침」의 사고 분류 체계를 준용하였다. 구체적으로 차량·시설 손상이나 인명피해를 수반하는 1종사고(열차충돌·열차탈선·차량화재 등), 운전취급 과오는 있으나 피해가 없는 2종사고(열차분리·이선진입 등), 시설물 고장 등으로 운행에 지장을 주는 3종사고(선로장애·송전고장 등)로 구분하였다. 이에 따라 사고(Accident), 고장(Failure), 운행장애(Disruption), 재난(Disaster)의 네 범주로 정리한 결과는 Table 1과 같다.
Table 1.
Four-Category Classification of Railway Operational Events with Actual Cases
Table 1은 각 이벤트의 범주, 발생 위치, 실제 사례를 정리한 것이다. 본 분류는 정상 운행과 비정상 운행을 구분하는 라벨링의 개념적 근거로 활용되며, 본 연구에서 정량적으로 검증하는 지연·이상 판정(2.6.5절)은 이 가운데 본선에서 운행시간 변동으로 관측 가능한 상황을 대상으로 한다. 여기서 이상 판정이란, LSTM 예측 통과시간 대비 실측값이 ±25% 범위를 벗어나는 구간을 비정상으로 분류하는 것을 의미한다.
시범구간은 경부선 하선의 일반선 구간으로 선정하였다. 해당 구간은 고속전용선이 아닌 일반선임에도 KTX, ITX, 새마을호, 무궁화호 등 운행 특성이 상이한 다양한 열차가 혼재 운행되어 모델의 적용성을 폭넓게 검증할 수 있다. 또한 선로 용량이 포화 상태에 가까워 지연과 운행장애가 반복적으로 발생하므로, 정밀 도착시간 예측 모델의 효용을 관찰하기에 적합하다. 다만 본 연구의 정량적 분석은 데이터 취득이 가능했던 단일 운행계통(No.1157 열차)에 한정하였으며, 복수 열차·방향으로의 확장은 향후 과제로 남긴다.
2.2. GNSS 네트워크 RTK기반 정밀 측위 데이터 수집
철도차량의 정밀 도착시간을 예측하려면 차량의 위치를 고정밀로 연속 측정할 수 있어야 한다. 이를 위해 본 연구는 다중 주파수·다중 위성군을 수신하는 GNSS 수신기와 안테나를 차상에 설치하고, 네트워크 RTK(Real-Time Kinematic) 방식으로 측위 보정을 수행하는 데이터 수집 체계를 구성하였다.
측위 데이터 수집 체계는 GNSS 안테나, GNSS 수신기, LTE 통신 단말, 그리고 보정 서버로 구성된다. GNSS 안테나와 수신기가 위성으로부터 위치 신호를 수신하면, LTE 단말이 이를 보정 서버로 전송하고, 보정 서버는 기준국 관측값을 이용해 생성한 보정 정보를 회신한다. 이 과정을 통해 위도·경도·고도 측정값의 오차를 실시간으로 보정하며, 전체 연계 구조는 Fig. 1과 같다.
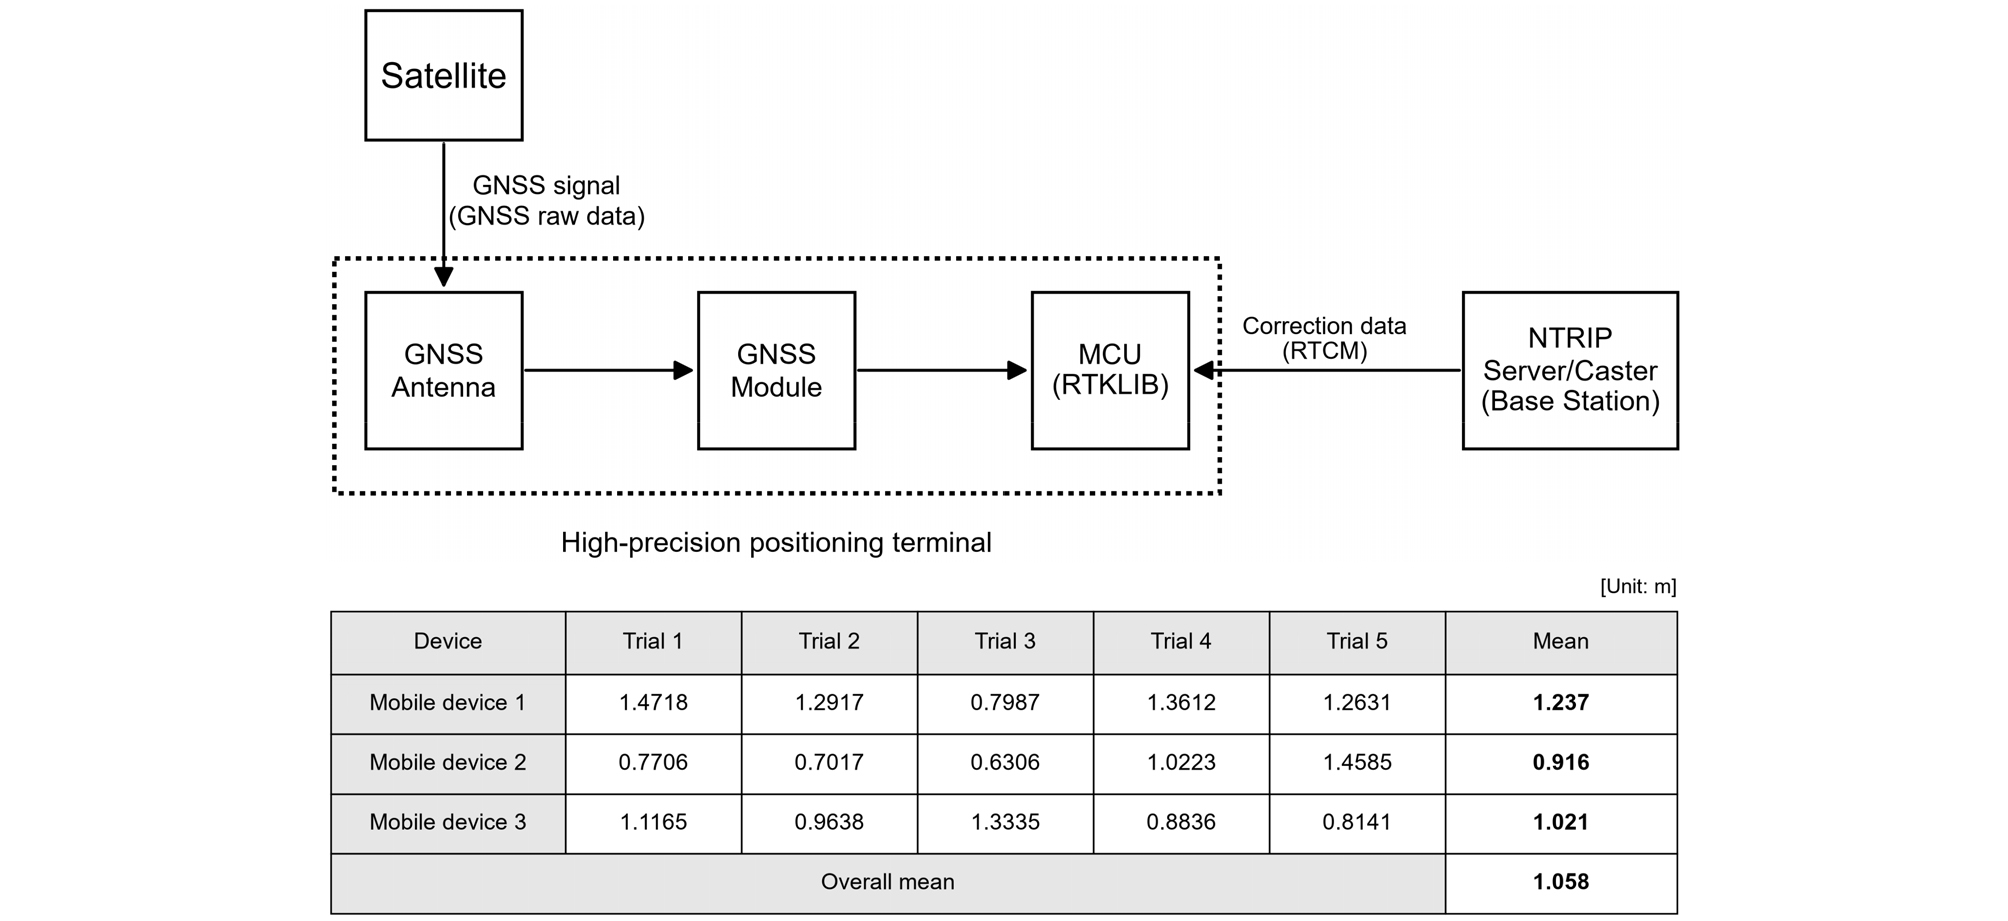
보정 적용 결과, 측위 정확도는 단독 측위(standalone GPS) 기준 약 5 m 수준에서 RTK 보정 후 약 105 cm수준으로 향상되었으며, 데이터는 1 Hz 주기로 수집되었다.
2.3. 가시광선 카메라 기반 선로주변 시설물 영상 수집
열차의 위치를 영상 기반으로 보조 추정하기 위해, 주행 중 선로 및 선로 주변 시설물을 촬영하고 이를 GPS 로그와 결합하는 영상 수집 체계를 구성하였다. 본 체계의 목적은 키로정 표지 등 위치 기준이 되는 시설물을 영상에서 인식하여, 해당 시점의 지리적 위치를 보조적으로 확보하는 데 있다.
고속 주행 환경에서는 저조도(약 10~30 lx) 조건에서도 안정적인 영상 품질이 요구된다. 이를 위해 계조, 다이내믹 레인지, 화질, 색감 등 빛 정보량을 고려하여 이미지센서 규격을 선정하고, 4K UHD 촬영기기를 열차 전방 선로의 소실점에 정렬하여 설치하였다. 또한 주행 진동에 의한 영상 흔들림을 저감하는 설치 구조를 적용하고, 디지털 이미지 보정과 데이터 용량 저감 기법을 함께 적용하였다. 전체 영상 장비 구성은 Fig. 2와 같다.
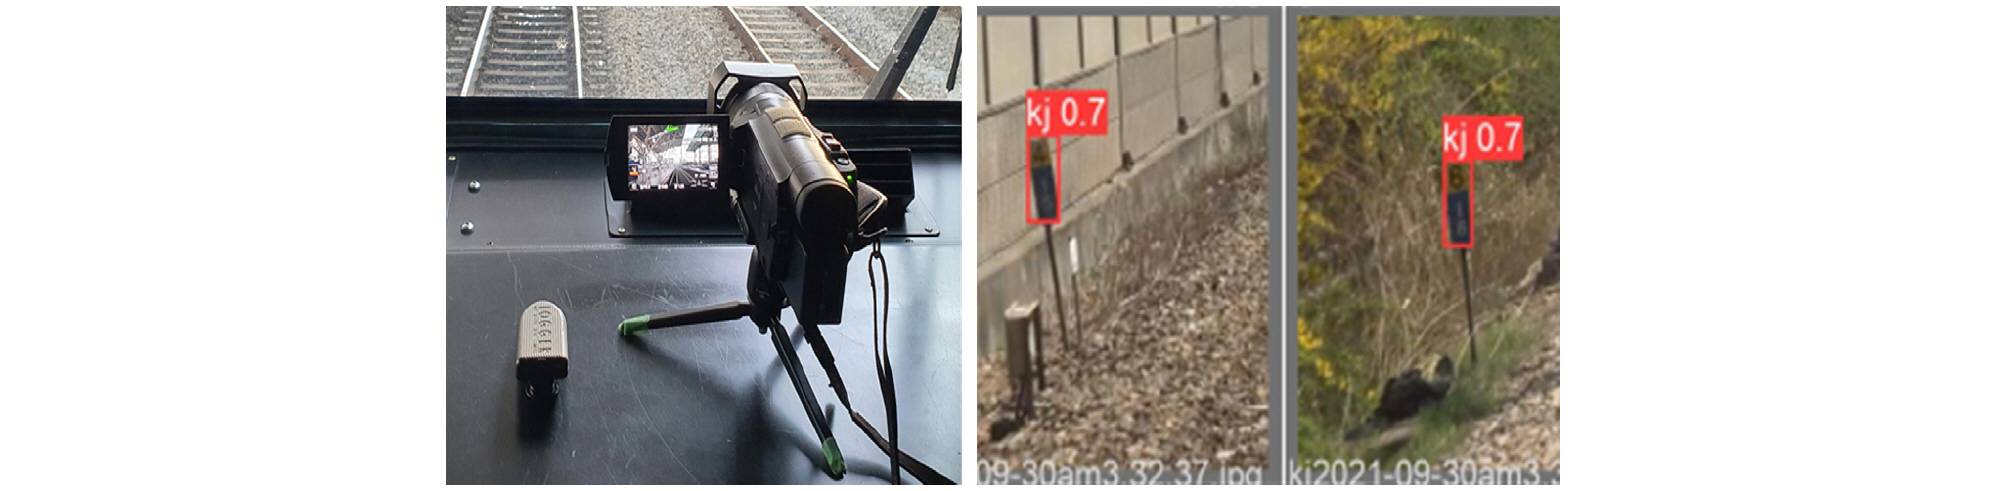
수집된 영상은 인공지능 객체 인식을 통해 선로와 시설물을 구별하고, 키로정 등 위치 기준 시설물을 검출한다. 검출된 시설물 정보는 구간별 GPS 로그와 결합되어 서버로 전송되고 데이터베이스로 구축된다. 이때 영상 프레임(29.97 fps)과 GPS 좌표 로그의 시각을 매칭하여 인식 객체의 지리적 위치를 산출하며, 시설물 인식 성능은 mAP 96.6%, precision 91.6% 등으로 나타났다.
2.4. 철도 시설물 이미지셋 구축 및 객체검출 모델 적용
선로 주변 시설물을 인식하기 위해, 대상 시설물의 샘플 영상을 수집하고 라벨링하여 학습용 이미지셋을 구축하였다. 인식률을 높이기 위해 시설물의 위치, 형상, 주변 환경이 다양하게 포함되도록 적응성 높은 샘플을 선별하였다. 구축된 이미지셋은 총 3,765장, 27개 클래스로 구성되며, 학습·검증 집합으로 80:20 분할하였다.
구축한 이미지셋을 이용하여 YOLO v5/Faster R-CNN 기반의 객체검출 모델을 학습하였다. Fig. 3과 같이 학습된 모델은 선로 주변에서 위치 기준이 되는 키로정 표지 등 대상 시설물을 검출하며, 검출 성능은 mAP@0.5 = 96.6%, precision 91.6%, recall 91.8%로 나타났다.
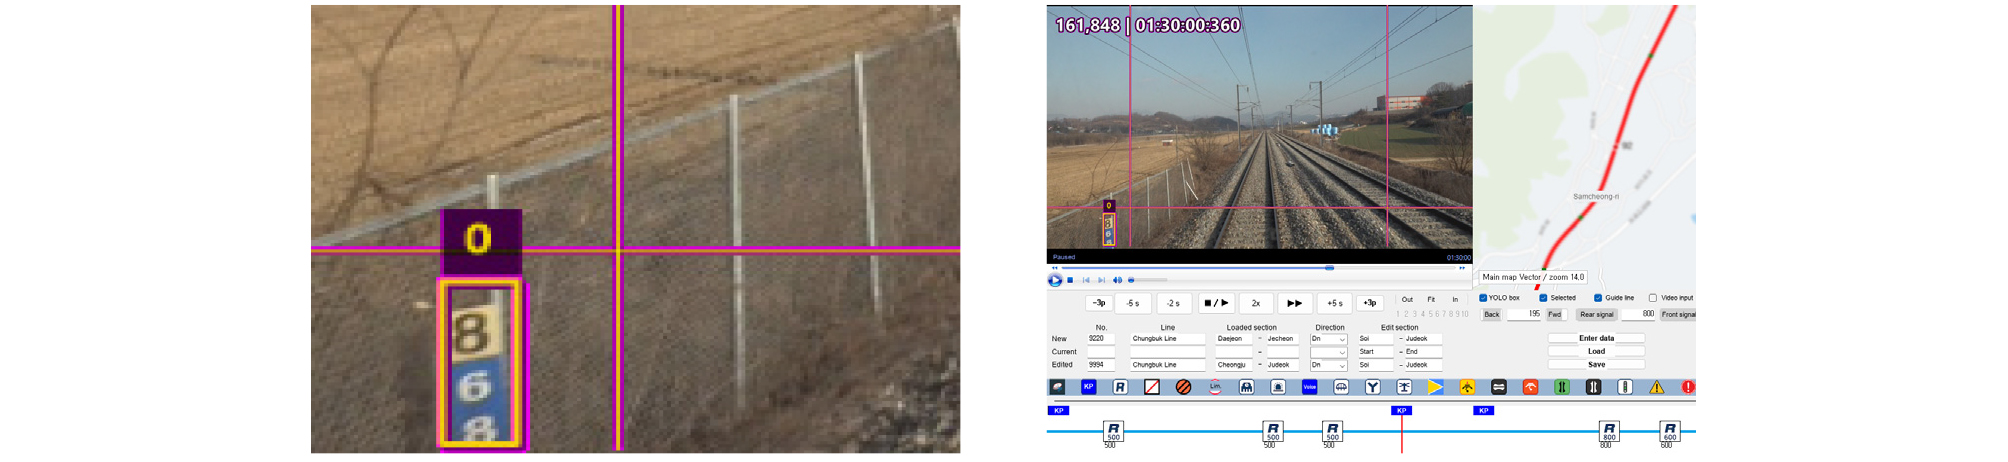
검출된 객체의 실제 지리적 위치는 영상과 GPS 로그의 시각 동기화를 통해 산출하였다. 구체적으로 29.97 fps로 취득된 영상 프레임의 시각과 GPS 좌표 로그의 시각을 매칭하여, 각 프레임에 대응하는 좌표를 부여하였다. 이를 통해 학습 모델이 인식한 시설물의 최종 위치를 획득하였다.
2.5. 시범구간 운행 데이터의 분석 및 가공
열차 속도에 따른 위치 신호를 수신하고 보정하기 위한 기본 요구사항을 정의하였다. 열차의 현재 속도와 ATS·ATP·ATC 신호는 시리얼 통신을 통해 차상 장치로부터 수신하며(수신 주기 1 Hz), 주파수 신호와 속도 신호를 연산하여 누적 주행거리를 산출한다. 이 과정에서 차륜의 공전·활주(wheel slip/skid)로 인한 속도 오차와 소요시간 이상치를 제거하여 신뢰성을 향상시킨다. 신호 수신·보정, 이상값 제거, CSV 저장에 대한 요구사항은 Table 2와 같다.
Table 2.
Requirements for ATS/ATP/ATC Signal Reception, Correction, and Data Processing
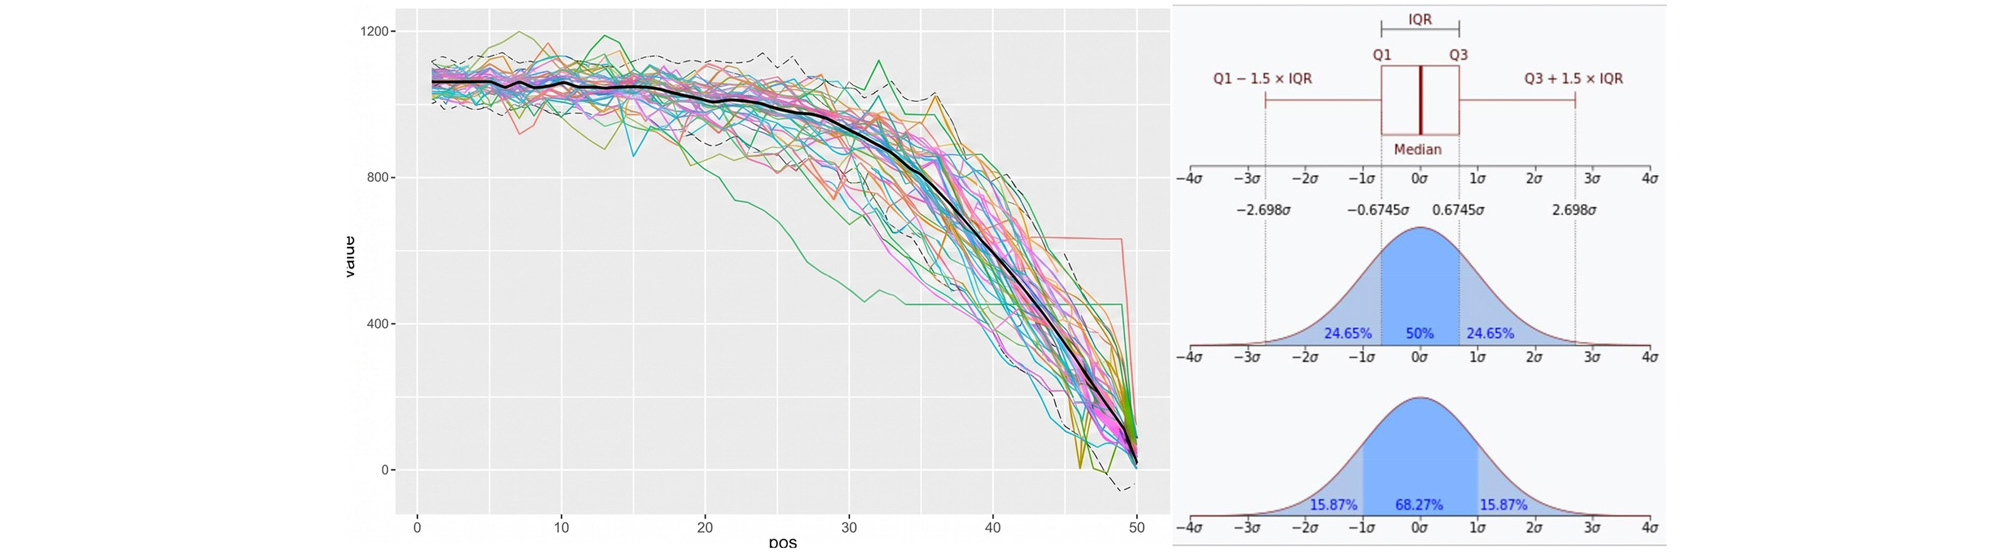
ATS·ATP·ATC 지상자의 정지 기준 지점을 기준으로, 정차하는 열차의 속도를 거리에 따라 표현하면 동일 등급 열차가 목표 지상자에 정지할 때까지의 표준 운행 곡선을 작도할 수 있다. Fig. 4는 정차 지점 500 m 전방부터 정지 지점까지의 GPS 좌표와 속도를 시각화하여 감속 추세를 나타낸 것이다. 운행별 속도 분포의 상위 25%와 하위 25% 범위를 파악하고 그 평균을 표준 감속 곡선으로 산출하였다. 이 표준 곡선을 이용하면 정차 목표점뿐 아니라 임의의 지점에서도 속도 변화 경향과 비정상 수치를 식별하여 도착시간을 예측·평가할 수 있다.
분석 대상은 경부선 하행 No.1157 열차의 운행이다. 공공데이터포털의 한국철도공사 열차운행정보 OpenAPI에서 확보한 역별 운행실적과, 해당 열차에 직접 탑승하여 취득한 GPS 좌표를 대조·결합하였다. 역별 운행실적은 2026년 3월 13일부터 5월 15일까지 No.1157 열차의 금요일 운행 10회로 구성되며, 위치 이력은 그중 8회 운행에서 취득한 GPS 위치 기록 9,019개로 이루어진다.
위치 이력을 0.2 km 단위로 구간 분할한 결과 총 15,204개의 구간 표본을 생성하였다. 단일 GPS 파일만 사용할 경우 654개 구간에 그쳤으나, 반복 운행 위치 이력을 결합함으로써 동일 열차번호의 반복 운행 패턴을 학습할 수 있는 수준의 자료를 확보하였다. 데이터 사양과 학습·검증·시험 분할 조건은 Table 3과 같다.
Table 3.
Specification and Data Split of Train No.1157 Position Records
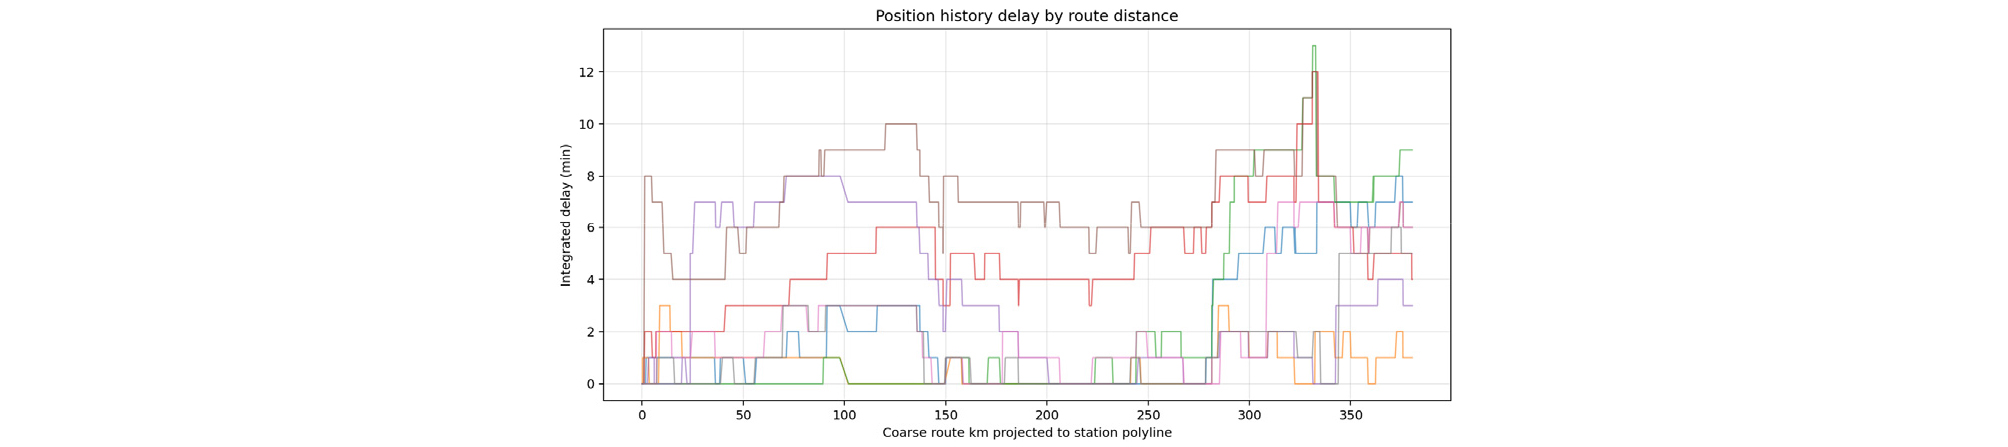
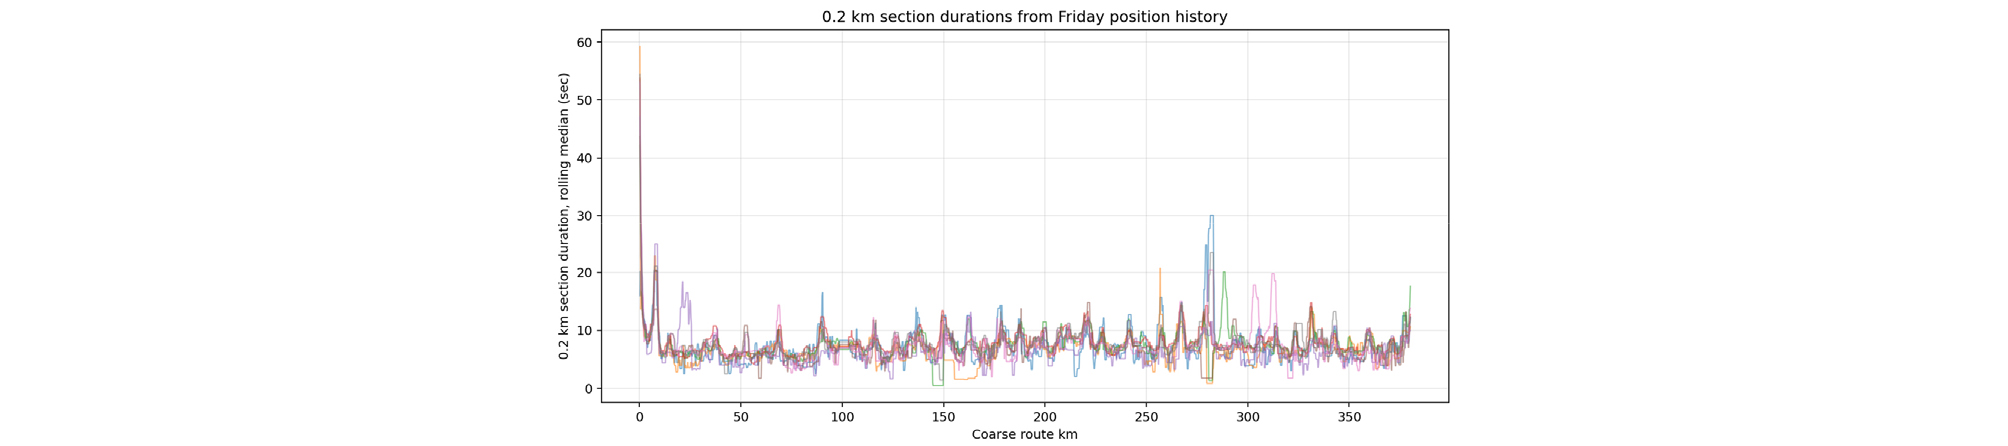
위치 이력에는 통합지연분이 포함되어 있어, 누적거리 기준 지연 변화와 구간 통과시간 변동을 함께 확인할 수 있다. Fig. 5는 운행일자별 누적거리 기준 통합지연분의 변화와 Fig. 6은 0.2 km 구간별 통과시간의 운행일자별 변동을 나타낸다. 지연 라벨의 임계값은 코레일 고객서비스헌장이 고속열차 지연을 도착역 5분 이상 지연으로 규정하는 점에 근거하여, 통합지연분이 5분 이상인 경우를 지연 상태로 정의하였다.
단, 본 연구에서는 단일 열차번호의 운행 패턴을 구간화하여 예측 모델을 실증 검증한 결과로 해석하며, 복수 열차·등급으로의 일반화는 본 연구의 범위를 넘어선다.
2.6. LSTM(Long Short Term Memory) 딥러닝 예측 알고리즘 검증
2.6.1. 모델 구조 및 입력 특징
본 연구는 No.1157 열차의 0.2 km 구간 자료를 이용하여 다음 구간의 통과 소요시간을 예측하는 LSTM 회귀 모델을 구성하였다. 모델은 다음 두 부분으로 이루어진다.
- 회귀부 : 입력 시퀀스로부터 다음 0.2 km 구간의 통과 소요시간 y′(초)를 추정한다.
- 이상판정부(후처리 규칙) : 실측 y가 y′의 ±25% 범위를 벗어나면 비정상으로 판정한다. 이는 학습된 분류기가 아니라 회귀 출력에 적용하는 규칙 기반 후처리이다.
입력은 직전 12개 0.2 km 구간의 [구간 시작 누적거리(키로정), 통과 시각, 요일, 구간 소요시간]으로 구성된 시퀀스이며, 출력은 다음 0.2 km 구간의 통과 소요시간이다. 입력 특징의 구성과 의미는 Table 4와 같다.
Table 4.
Input Features of the LSTM Prediction Model
2.6.2. LSTM 갱신식
LSTM은 과거 구간의 통과시간 흐름을 은닉상태에 저장하여 다음 구간 소요시간을 예측한다. 그 게이트 메커니즘은 Hochreiter & Schmidhuber(4)가 제안한 Constant Error Carousel 구조에 기반한다. 시점 에서 입력벡터를 , 은닉상태를 , 셀상태를 라 할 때 핵심 갱신식은 식 (1), (2)와 같다.
(1) , , ,
(2) ,
※ ⊙는 원소별 곱셈(Hadamard product, 아다마르 곱)
2.6.3. 학습 설정 및 데이터 분할
회귀 손실은 평균절대오차(MAE)를 사용하였으며, 이상판정과 지연 라벨은 다음과 같이 정의하였다.
- 회귀손실 : L=MAE,
- 이상판정 : |y-y′|/y′ > 0.25,
- 지연라벨 : 통합지연분 ≥ 5분
여기서 y는 실제 0.2 km 구간 통과 소요시간(s), y′는 LSTM의 예측값(s)이다.
운행일자 단위의 데이터 누수를 방지하기 위해 학습·검증·시험 집합을 날짜 기준으로 분할하였다. 학습일은 2026년 3월 13일, 3월 20일, 4월 3일, 4월 10일, 4월 24일이며, 검증일은 5월 1일, 시험일은 5월 8일과 5월 15일이다. 시험 표본은 총 3,775개 0.2 km 구간이다. LSTM 모델은 은닉 유닛 64개와 32개의 2개 층(각 층 뒤 드롭아웃 0.2)으로 구성하였고, 회귀 손실은 평균절대오차(MAE)를 사용하였다. 옵티마이저는 Adam(학습률 0.001), 배치 크기는 256, 학습 에폭은 최대 50회로 설정하되 검증 손실 기준 조기종료(patience 8)를 적용하였다. 보고 성능은 서로 다른 3개 시드(seed)로 학습한 결과의 평균이다.
2.6.4. 예측 성능 비교
시험 표본에서 LSTM, 위치별 과거 중앙값, 직전 구간 소요시간 기준모델의 MAE, RMSE, MAPE, P90을 비교한 결과는 Table 5와 같다. 위치별 과거 중앙값 기준모델은 각 0.2 km 구간에서 과거 4회 운행의 통과시간 중앙값을 다음 운행의 예측값으로 사용한다.
Table 5.
Prediction Performance of LSTM and Two Baseline Models
| Model | MAE | RMSE | MAPE | P90 |
| LSTM (mean of 3 seeds) | 5.419 s | 22.456 s | 63.9% | 8.523 s |
| Historical median by position | 4.434 s | 14.713 s | 53.7% | 7.407 s |
| Previous-section travel time | 6.696 s | 28.836 s | 83.9% | 11.704 s |
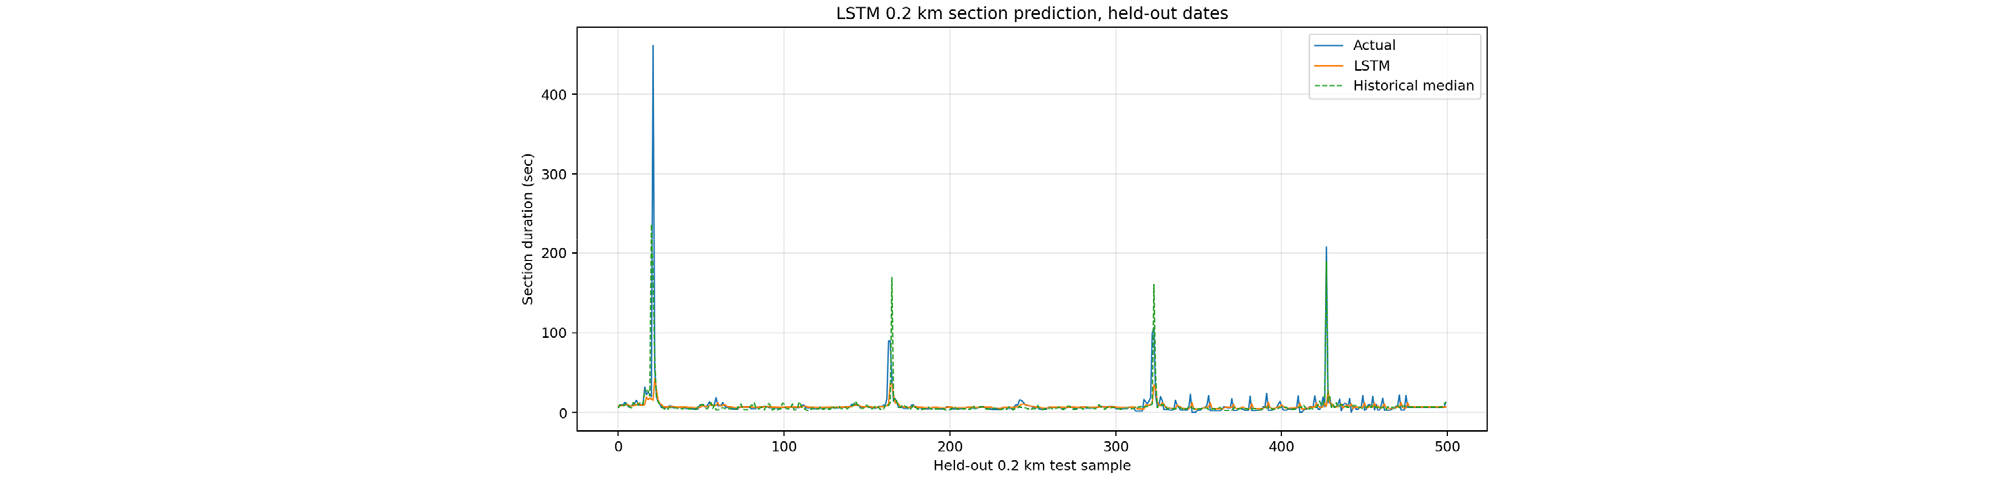
LSTM(MAE 5.419초)은 직전 구간 소요시간 기준모델(MAE 6.696초)보다 낮은 오차를 보였으나, 위치별 과거 중앙값 기준모델(MAE 4.434초)보다는 우수하지 않았다. 이는 동일 열차번호가 정해진 시각표에 따라 반복 운행하는 환경에서는 위치별 이력 통계가 강한 기준선으로 작용함을 의미한다. 따라서 본 결과는 LSTM의 절대적 우수성을 주장하기보다, 실제 탑승으로 취득 가능한 특정 열차의 위치 이력으로 예측 절차를 재현하였다는 근거로 해석하는 것이 적절하다. Fig. 7은 실측 소요시간, LSTM 예측값, 위치별 과거 중앙값을 0.2 km 구간 단위로 비교한 결과이다.
2.6.5. 이상판정 결과 및 해석
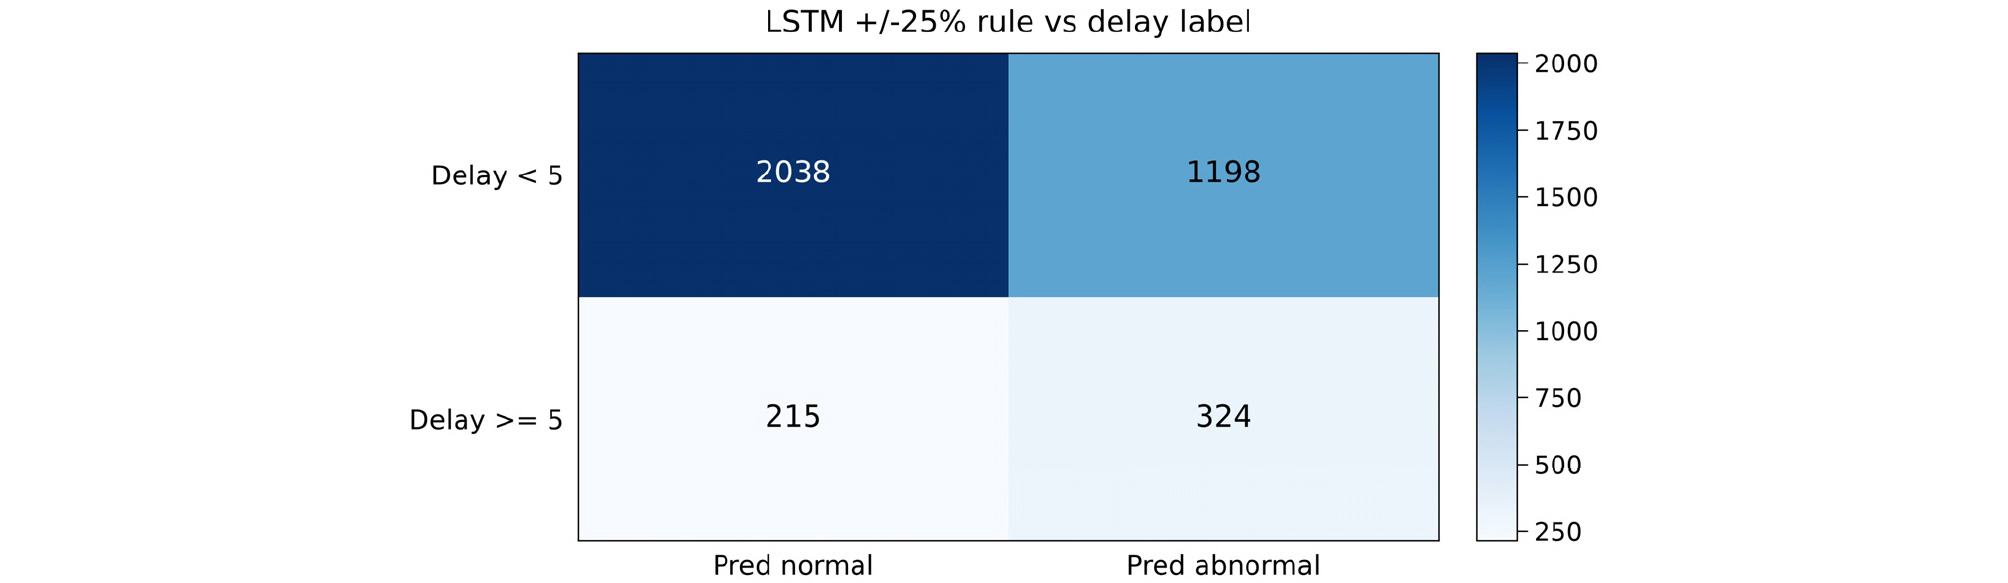
Table 6은 LSTM 예측값에 ±25% 임계를 적용하여 정상·비정상을 판정한 결과이다. ±25% 임계 기준은 지연 상태의 일부를 포착하여 Recall 60.1%를 보였으나, Precision은 21.3%로 오탐이 많았다. 이는 구간 통과시간의 급격한 변화가 항상 실제 지연을 의미하지는 않기 때문이다. 따라서 본 이상판정은 최종 성능을 주장하는 결과가 아니라 예비 판정 규칙으로 제시하며, 향후 정차시간, 신호대기, 선행열차 간격, 장애 이벤트 라벨을 추가하여 정밀화할 필요가 있다. 판정 결과의 혼동행렬은 Fig. 8과 같다.
Table 6.
Counts and Metrics of the ±25% Threshold Anomaly Detection
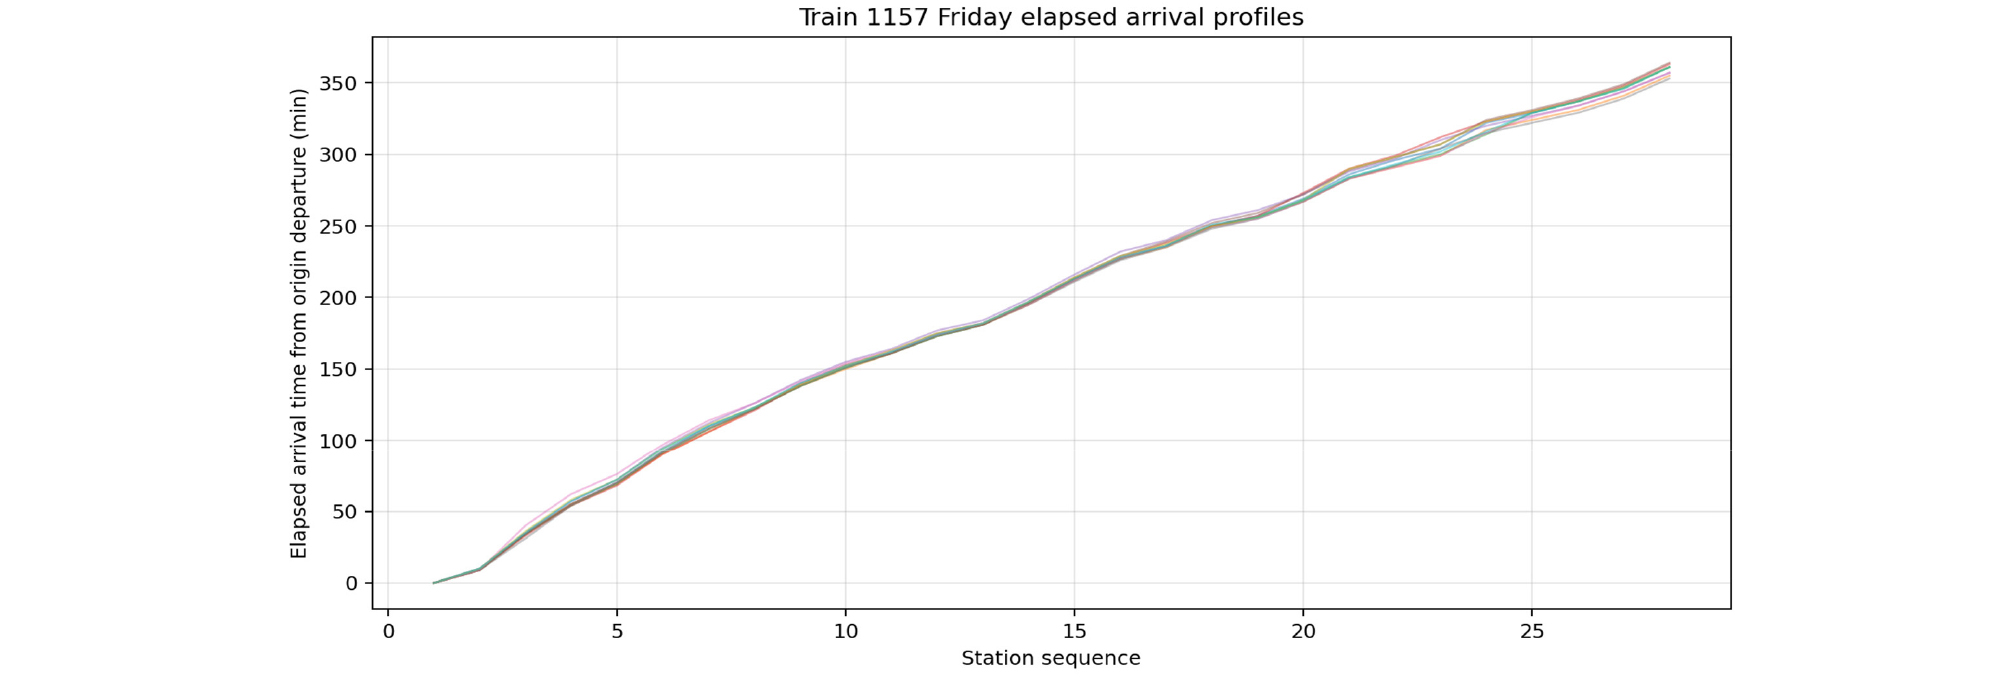
한편 Fig. 9는 시험 기간 중 No.1157 열차의 금요일 운행에 대한 역별 누적 도착시간 곡선으로, 동일 운행계통 내에서 도착 패턴이 거의 일치함을 보여준다. 이는 위치별 이력 통계가 강한 기준선으로 작용하는 배경을 뒷받침한다.
2.6.6. 소결
본 절에서는 경부선 하행 No.1157 열차의 금요일 반복 운행자료로 0.2 km 구간 통과시간 데이터셋(총 15,204개 구간)을 구축하고, 누적거리·통과시각·요일·구간 소요시간을 입력으로 하는 LSTM 모델을 학습하였다. 시험 표본에서 LSTM의 MAE는 5.419초로 직전 구간 기준모델보다 낮았으나 위치별 과거 중앙값 기준모델보다는 높았다. 이는 단일 열차의 반복 운행에서 위치별 이력 정보가 강한 기준선으로 작용함을 의미하며, 본 연구의 LSTM 결과는 실데이터 기반 예측 절차의 재현 가능성을 확인하는 근거로 해석된다.
2.7. 선로작업자용 열차 접근 경고 애플리케이션
앞서 구축한 도착시간 예측 절차를 작업자 안전에 응용하기 위해, 선로 주변 작업자에게 열차 접근을 경보하는 모바일 애플리케이션을 개발하였다. 열차는 지정된 선로를 운행하므로, 열차의 운행 패턴을 이용하면 선로상 특정 지점에 대한 접근 시간을 예측할 수 있다. 따라서 작업자의 선로상 위치 좌표와 근접한 열차의 좌표를 결합하면, 열차가 작업자 위치를 통과할 때까지의 잔여 시간을 산출할 수 있다. 본 앱은 제초 등 선로변 작업을 수행하는 작업자에게 이 잔여 시간을 기반으로 열차 접근을 경보한다.
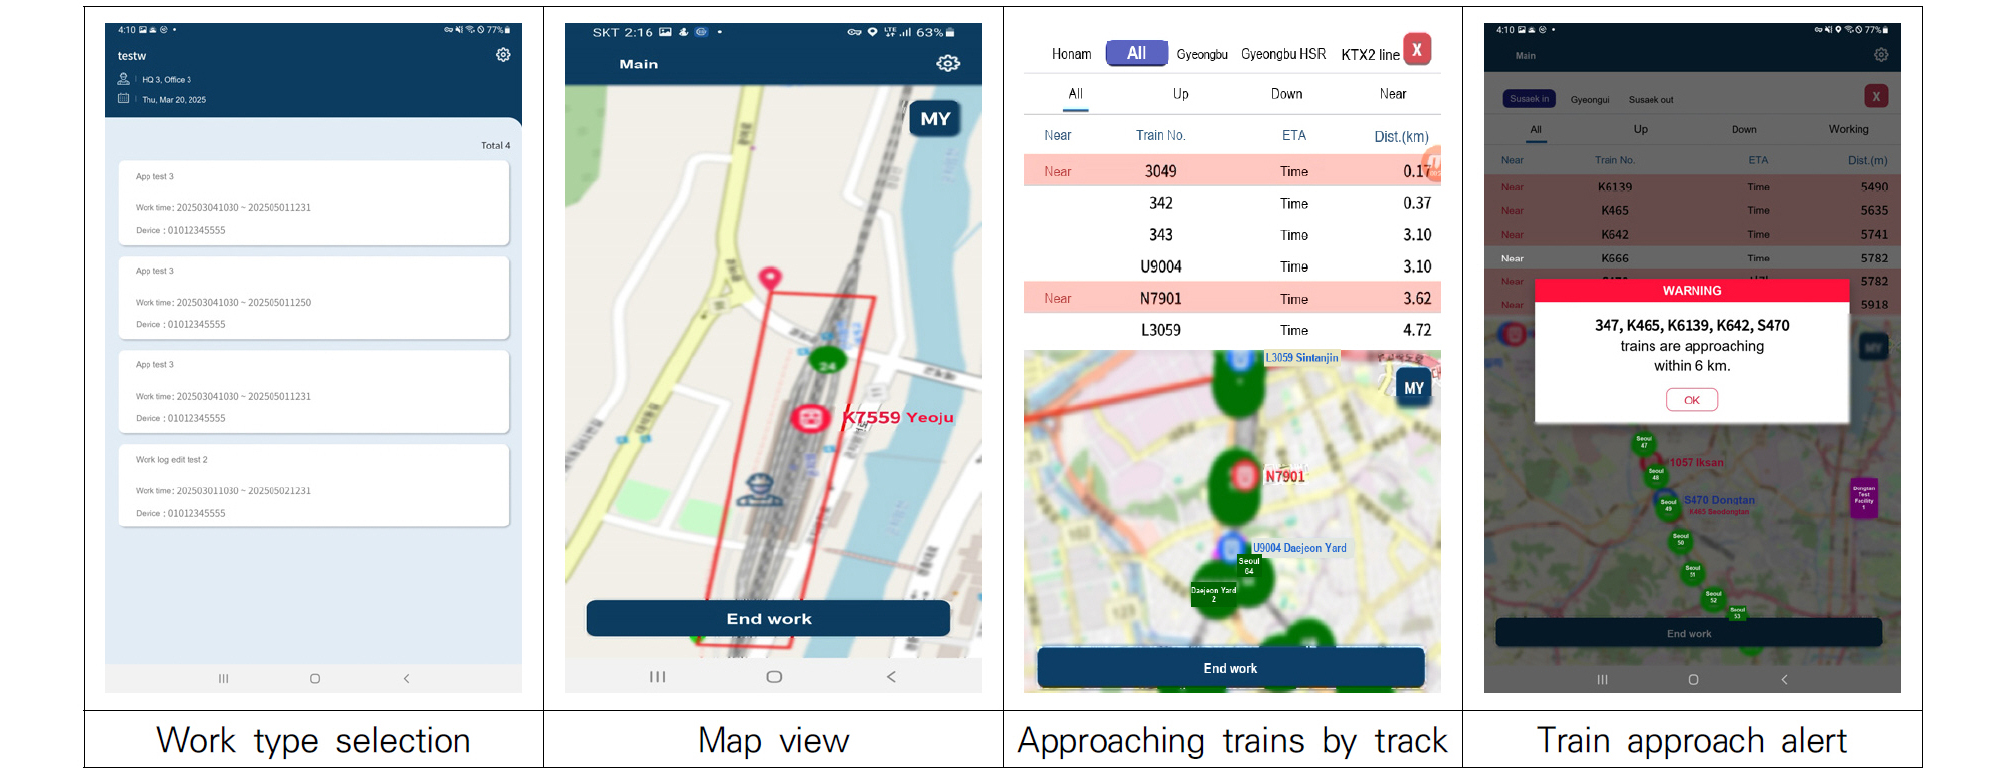
작업자의 위치는 모바일 단말기의 GPS와 RTK, KASS 등의 정밀 보정을 통해 운행선상에서 파악한다. 소음과 분진이 발생하는 작업 환경에서도 작업자가 인지할 수 있도록, 빛·경고음·진동 등 복합적인 알림 수단을 제공하며, 열차와의 거리에 따라 단계별 위험 경보를 발령한다. 또한 IoT 경보기와 연동하여 철도차량의 좌표와 지연 예측 정보를 반영한 선제적 경보 체계를 구성하였다. 앱의 주요 기능 화면은 Fig. 10과 같으며, 작업 종류 선택, 지도 화면, 선로별 접근 열차 정보, 열차 접근 경보 화면으로 구성된다.
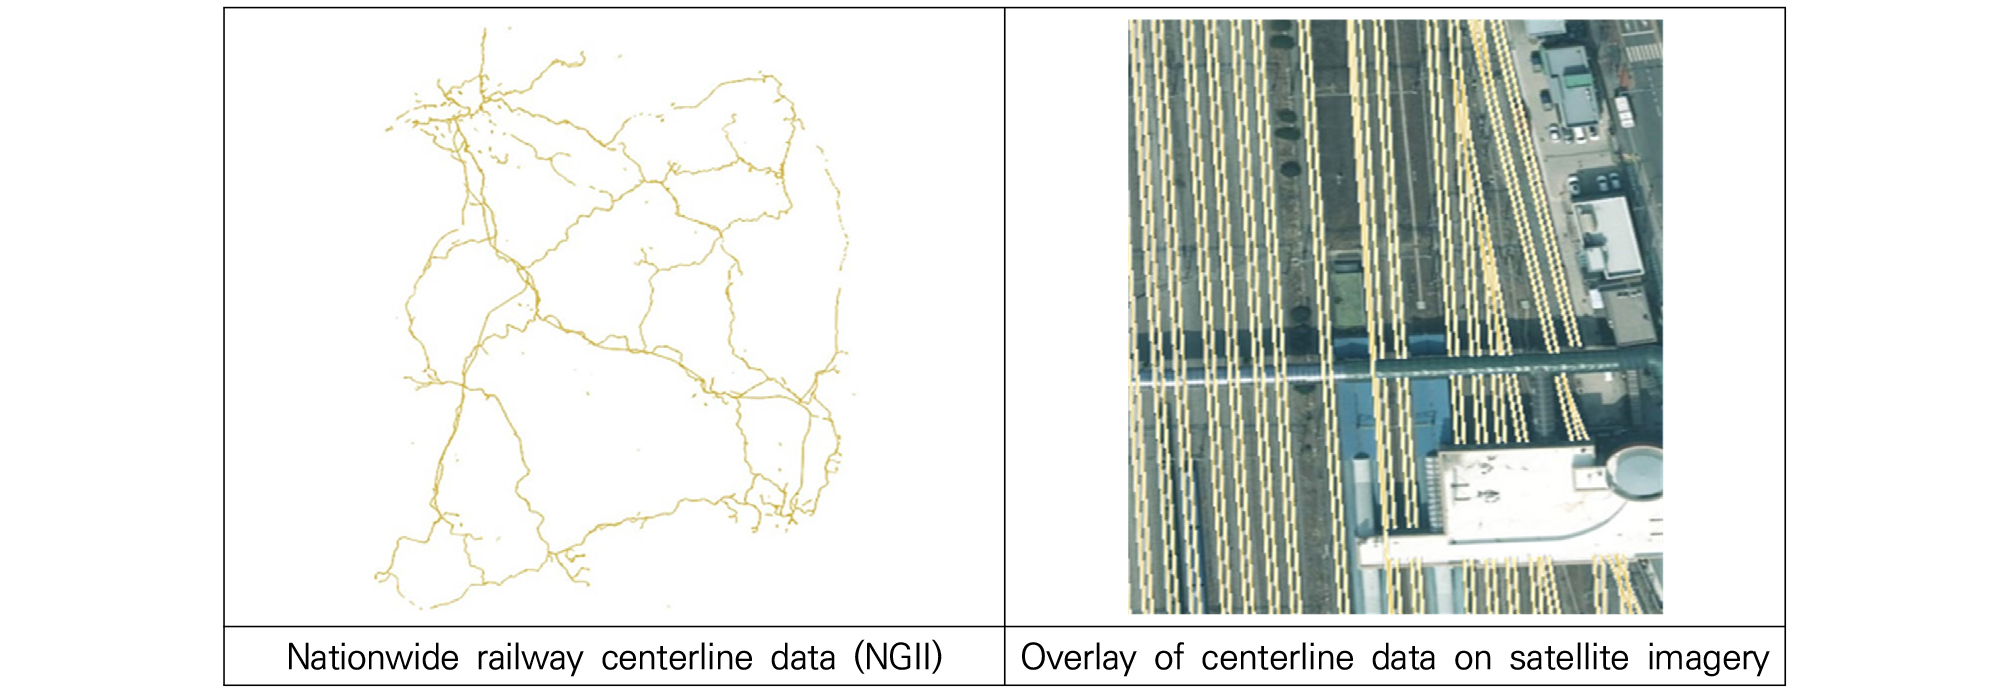
열차 위치 판정과 위치 보정을 위한 기준 선로로는 국토지리정보원 연속수치지형도의 철도중심선 데이터를 활용하였으며, 좌표계는 GRS80(EPSG:5186)을 적용하였다. 선로를 세분화하고 그 속성(상·하행)을 지정함으로써, 작업자가 위치한 선로와 열차의 운행 방향을 대조하여 경보의 우선순위를 부여한다. 예컨대 하행 열차가 접근할 때 하행 선로에서 작업하는 작업자에게 상행 선로 작업자보다 우선하여 경보를 발령한다. 이는 수도권과 같이 다수 열차가 밀집 운행하는 환경에서 접근 방향과 무관한 경보가 과다하게 발생하여 효용이 저하되는 문제를 완화하기 위함이며, 접근 선로의 성격을 분리하여 경보의 선택성을 높인다.
작업자 위치 기반 경보의 신뢰성은 기준 선로 데이터의 정확성에 의존한다. 이를 확인하기 위해 Fig. 11과 같이 국토지리정보원 철도중심선 데이터를 위성사진과 대조하여 전국 열차 운행선 데이터의 정합성을 검토하였으며, 작업자 위치 기반 열차 접근 경보에 활용 가능한 수준임을 확인하였다.
3. 결 론
본 연구는 공공데이터포털의 열차운행정보 OpenAPI와 실차 탑승으로 취득한 GPS 데이터를 결합하여 단일 운행계통(경부선 하행 No.1157 열차)의 0.2 km 구간 통과시간 데이터셋 15,204건을 구축하고, 이를 이용해 LSTM 기반 예측 모델과 과거 이력 기반 베이스라인을 비교·실증하였다. 데이터 누수를 방지하기 위해 학습·검증·시험 집합을 날짜 기준으로 분할하고, MAE를 비롯한 지표로 성능을 평가하였다.
실험 결과, LSTM(MAE 5.419초)은 직전 구간 기준모델(MAE 6.696초)보다 우수하였으나 위치별 과거 중앙값 기준모델(MAE 4.434초)보다는 우수하지 않았다. 이는 동일 열차가 정해진 시각표에 따라 반복 운행하는 정형적 환경에서는 단순한 위치별 이력 통계가 강력한 기준선으로 작용함을 보여준다. 따라서 본 연구는 특정 모델의 절대적 우수성 보다는 실데이터에 기반한 재현 가능한 예측 파이프라인을 구축하고 적정 베이스라인 설정의 중요성을 실증적으로 제시하였다는 데 의의가 있다.
본 연구가 제시한 거리 기준의 구간 통과시간 예측 절차는 운전자의 주관적 판단에 의존하지 않고 초 단위의 결정론적 도착 정보를 산출할 수 있다. 이러한 정보는 동일 노선을 반복 이용하는 MaaS 기반 공유 모빌리티 서비스나, 정밀 위치 추적이 어려운 교통·운송 분야에 활용될 수 있으며,(5) 선로작업자를 위한 열차 접근 경보 등 안전 관리 응용으로 확장될 가능성이 있다.
다만 본 연구는 다음과 같은 한계를 가진다. 첫째, 분석 대상이 단일 열차번호의 단방향 금요일 운행으로 한정되어, 다양한 열차 등급·노선·시간대로의 일반화에는 추가 검증이 필요하다. 둘째, ±25% 임계에 기반한 이상판정은 Recall 60.1%, Precision 21.3%로 오탐이 많아 예비 판정 규칙 수준에 머무른다. 셋째, GNSS 정밀 측위, 영상 기반 시설물 인식, 경고 애플리케이션 등 시스템 구성요소는 본 연구에서 정량적으로 검증되지 않았다.
향후 연구에서는 복수 열차·노선으로 데이터를 확장하여 모델의 일반화 성능을 검증하고, 정차시간·신호대기·선행열차 간격·장애 이벤트 등의 라벨을 추가하여 이상판정의 정밀도를 높일 필요가 있다. 또한 LSTM 외의 시계열 모델과 위치별 이력 통계를 결합하는 방안을 검토하고, 정밀 측위 및 경고 시스템의 정량적 현장 검증을 수행함으로써 실용적 안전관리 체계로 발전시킬 수 있을 것이다.